

El 24 de julio de 2026, Jensen Huang escribió su primer post en la historia de su cuenta de X. No fue para anunciar un chip: fue para publicar una carta, Open Weights and American AI Leadership, pidiéndole a Washington que no restrinja los modelos de inteligencia artificial cuyos pesos, la parte que hace que un modelo funcione, se pueden descargar libremente.
Salió con 25 firmas. En veinticuatro horas tenía 50. Para el 28 de julio ya eran más de 150 organizaciones, y entre ellas estaban Microsoft, Meta, AMD, Cisco, Cloudflare, GitHub y, llamativamente, OpenAI y Google, dos de las tres empresas cuyo negocio consiste en vender modelos cerrados. Once millones de personas vieron el post. Anthropic y xAI no firmaron.
El detonante había ocurrido ocho días antes: el 16 de julio, la empresa china Moonshot AI liberó Kimi K3, un modelo de pesos abiertos que entró directo al tercer lugar del Artificial Analysis Intelligence Index, por encima de varios modelos frontera estadounidenses. El índice de semiconductores de Filadelfia cayó 12.5 % la semana siguiente. Y el 3 de agosto, Alibaba lanzó Qwen 3.8 con la promesa de publicar también sus pesos.
La cobertura internacional lo contó como un capítulo más de la rivalidad Estados Unidos–China. Desde México conviene leerlo al revés: la discusión es de ellos, pero el beneficio es nuestro.
¿Qué pasó con esto?
El 16 de julio, Moonshot AI lanzó Kimi K3: 2.8 billones de parámetros, contexto de un millón de tokens, tercer lugar mundial en el índice de Artificial Analysis. Sus pesos se hicieron públicos el 27 de julio. Cualquiera puede descargarlos hoy.
El 24 de julio, la carta de Huang argumentó que los pesos abiertos son infraestructura estratégica: permiten construir sin entrenar un modelo desde cero ni pagar precios de frontera por cada tarea, reparten la competencia, evitan quedar atrapado con un solo proveedor y dejan que una comunidad entera de investigadores encuentre fallos.
La analogía explícita es el software abierto de los ochenta: que los escépticos quisieron restringir y que hoy sostiene internet, a las grandes tecnológicas y al propio gobierno estadounidense.
OpenAI firmó ese mismo viernes; Google, el sábado. Sam Altman escribió que quiere que EE. UU. gane tanto en modelos abiertos como propietarios. Elon Musk respaldó públicamente a Huang. Anthropic respondió el 27 con su propia posición: nunca ha pedido prohibir los modelos abiertos, dice, pero sí controles más estrictos sobre chips, la destilación industrial y pruebas de seguridad obligatorias.
El 3 de agosto, Alibaba presentó Qwen 3.8, cuyo modelo insignia se perfila como el lanzamiento de pesos abiertos más grande de la historia. Al cierre de esta edición, los pesos aún no aparecían en Hugging Face ni se conocía la licencia.
Lo que la carta realmente revela
La semana dejó una señal más importante que la propia carta: la apertura pasó de ser una postura ideológica de activistas a ser la posición mayoritaria del mercado. Cuando OpenAI y Google, que venderían más si los modelos chinos abiertos desaparecieran, firman a favor de que existan, están reconociendo que el ecosistema abierto les conviene: más desarrolladores construyendo, más competencia empujando precios, más cómputo vendido.
La discusión de seguridad nacional que motivó la carta es legítima, pero no es el tema de este artículo. Lo que importa aquí es lo que quedó demostrado sobre la mesa: nadie en la industria, ni siquiera sus actores más poderosos, cree que la IA de punta pueda volver a ser propiedad exclusiva de quien la entrena.
La evidencia: lo abierto ya alcanzó (casi) a lo cerrado
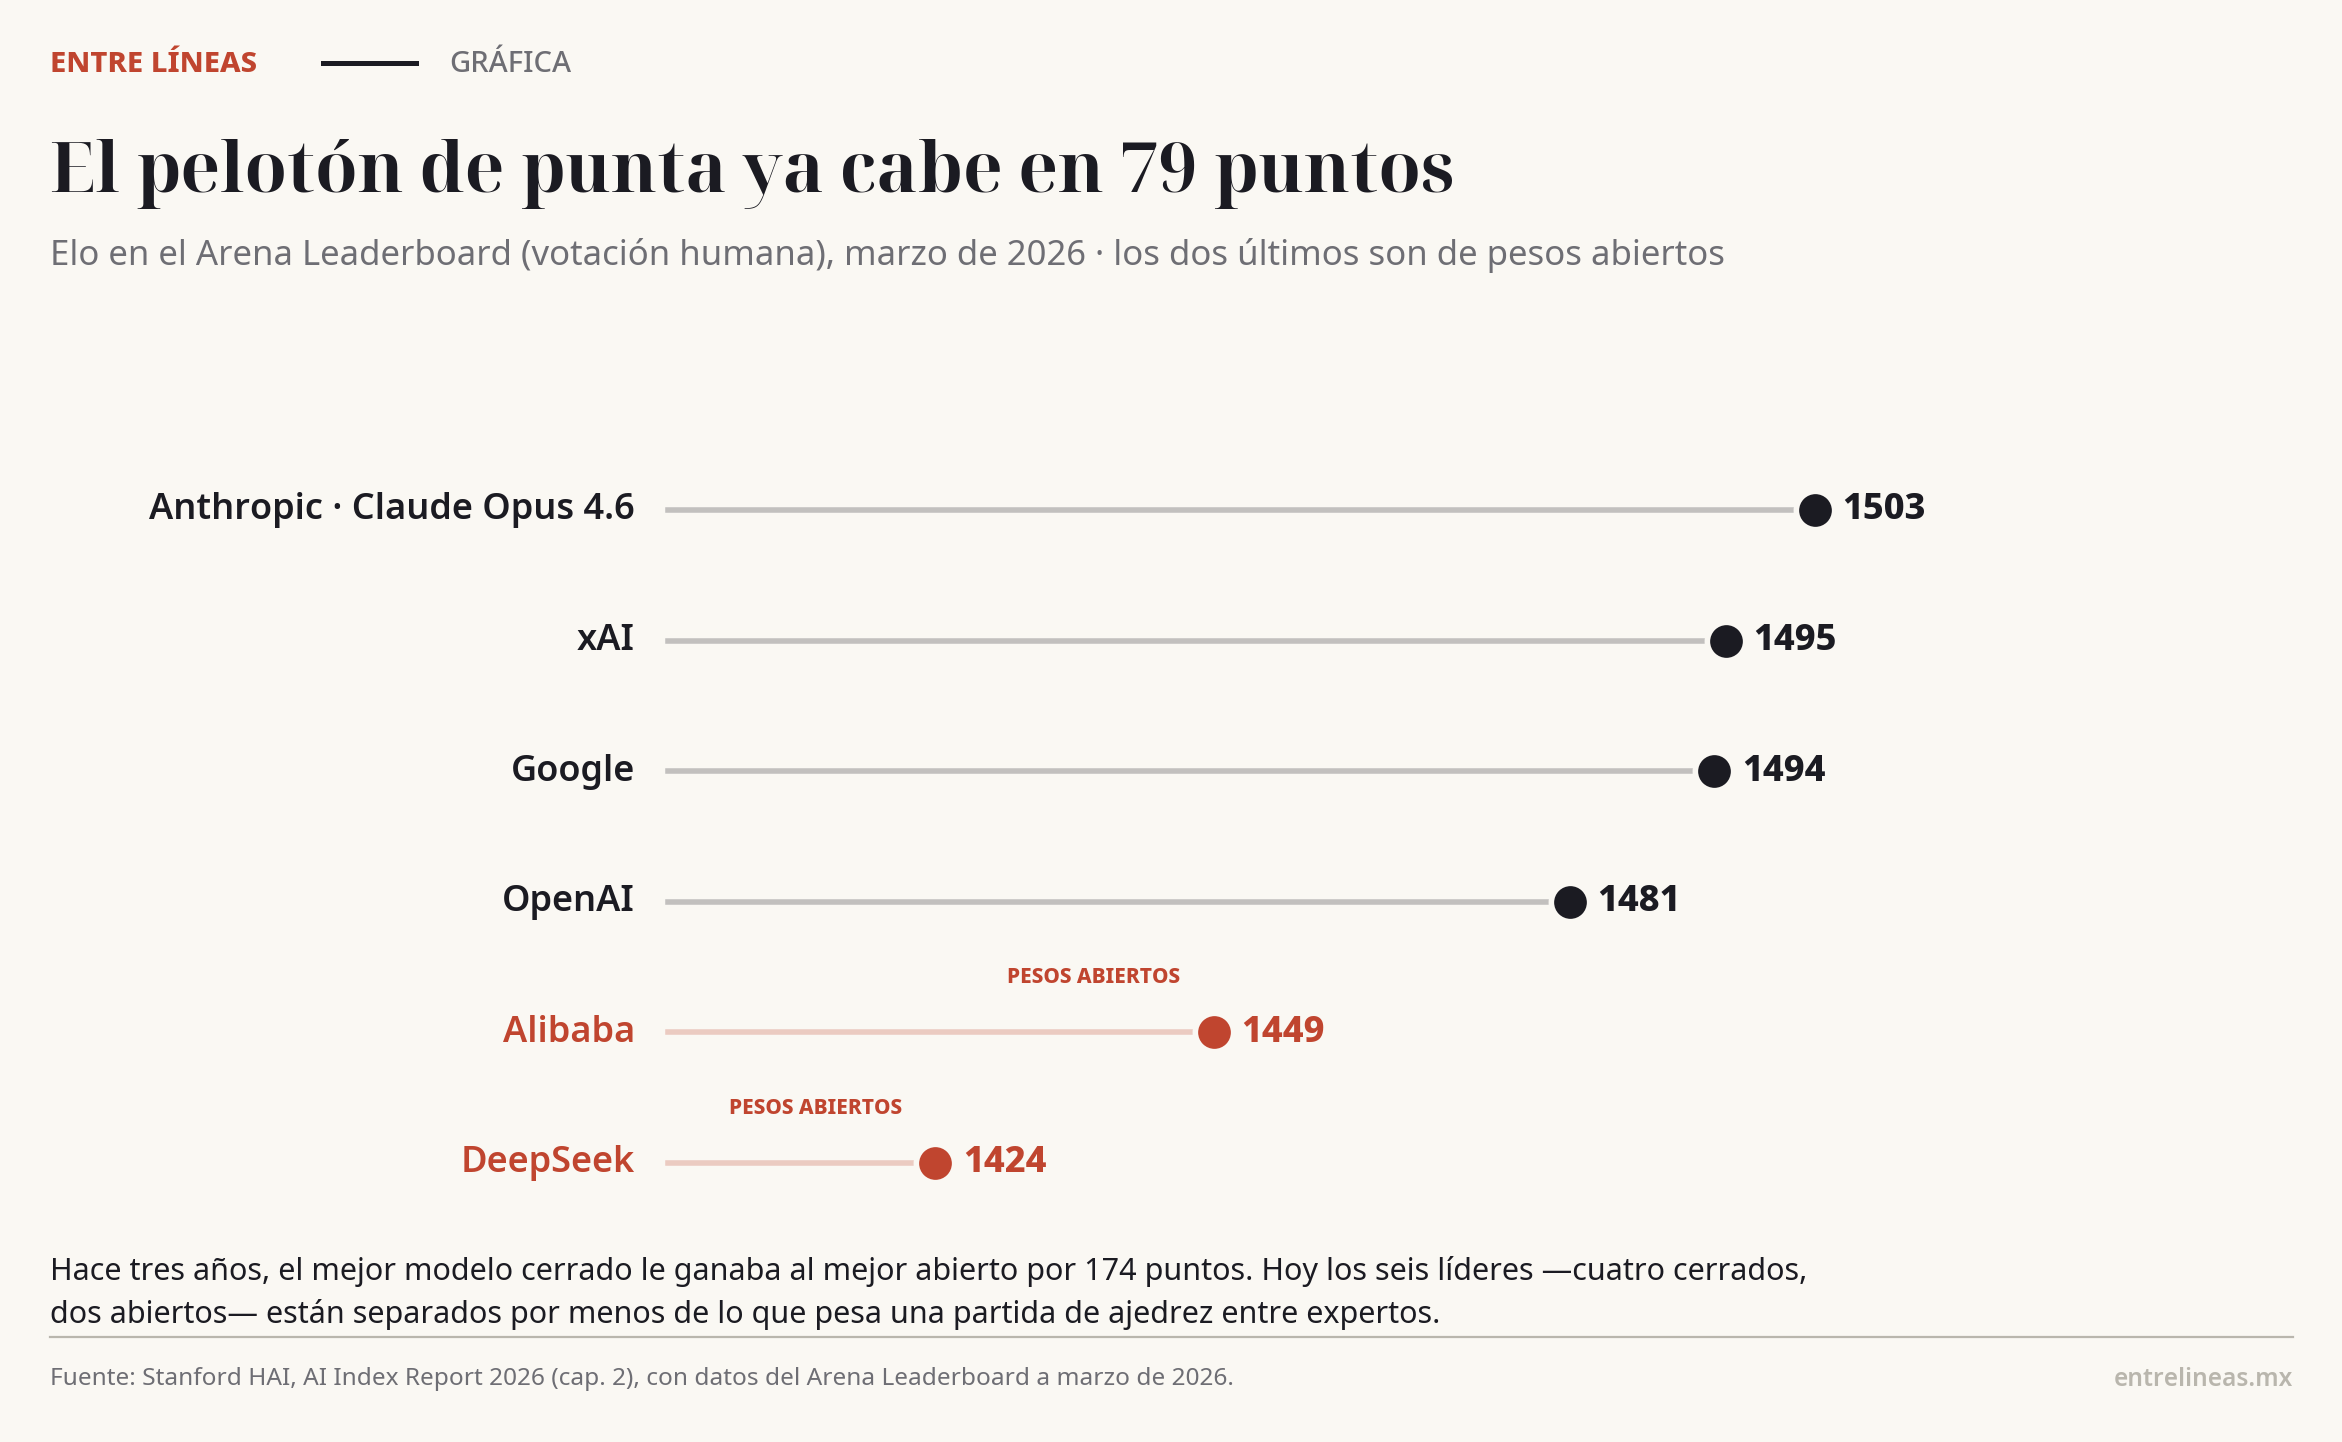
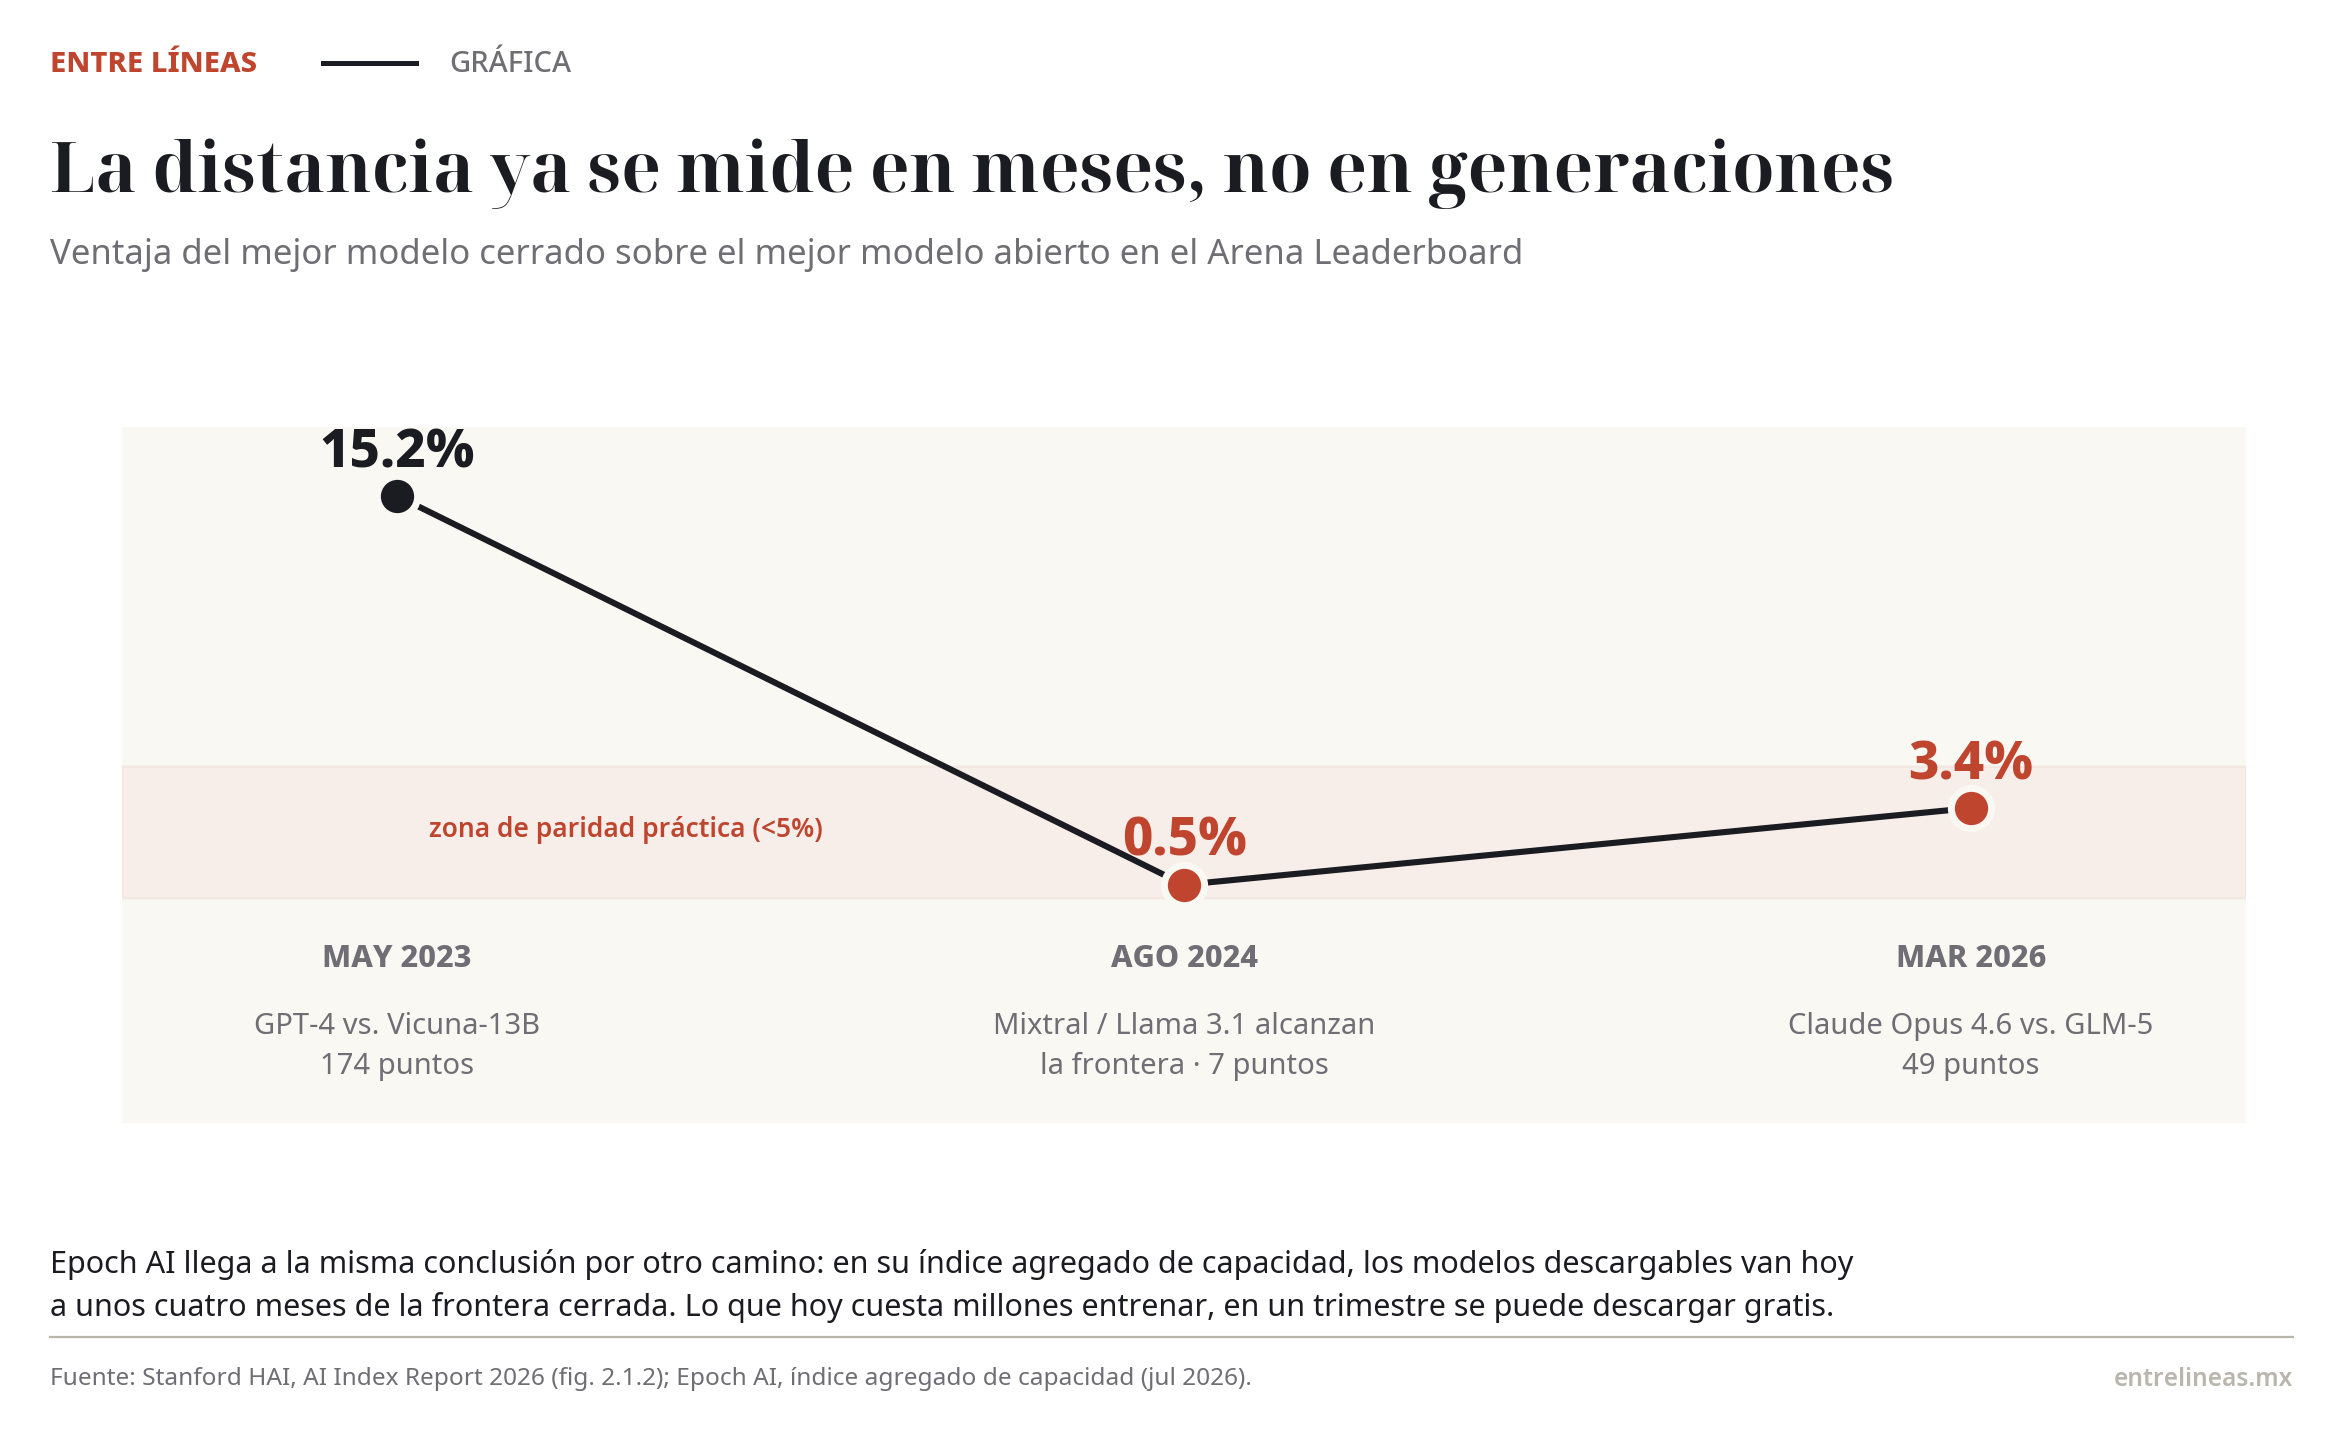
Esto no es una impresión. El AI Index 2026 de Stanford, la referencia más citada del estado de la tecnología, lo mide con votación humana en el Arena Leaderboard:
En mayo de 2023, el mejor modelo cerrado (GPT-4) superaba al mejor abierto por 174 puntos ELO, una ventaja de 15.2 %.
En agosto de 2024 la brecha se cerró a 7 puntos: 0.5 %.
En marzo de 2026, con modelos cerrados más fuertes, la distancia es de 49 puntos: 3.4 %. Los seis laboratorios líderes caben en 79 puntos, y dos de ellos, Alibaba y DeepSeek, publican sus pesos.
Epoch AI lo confirma desde otro ángulo: en su índice agregado de capacidad, los modelos descargables van a unos cuatro meses de la frontera cerrada. Lo que hoy cuesta cientos de millones entrenar, un trimestre después circula gratis.
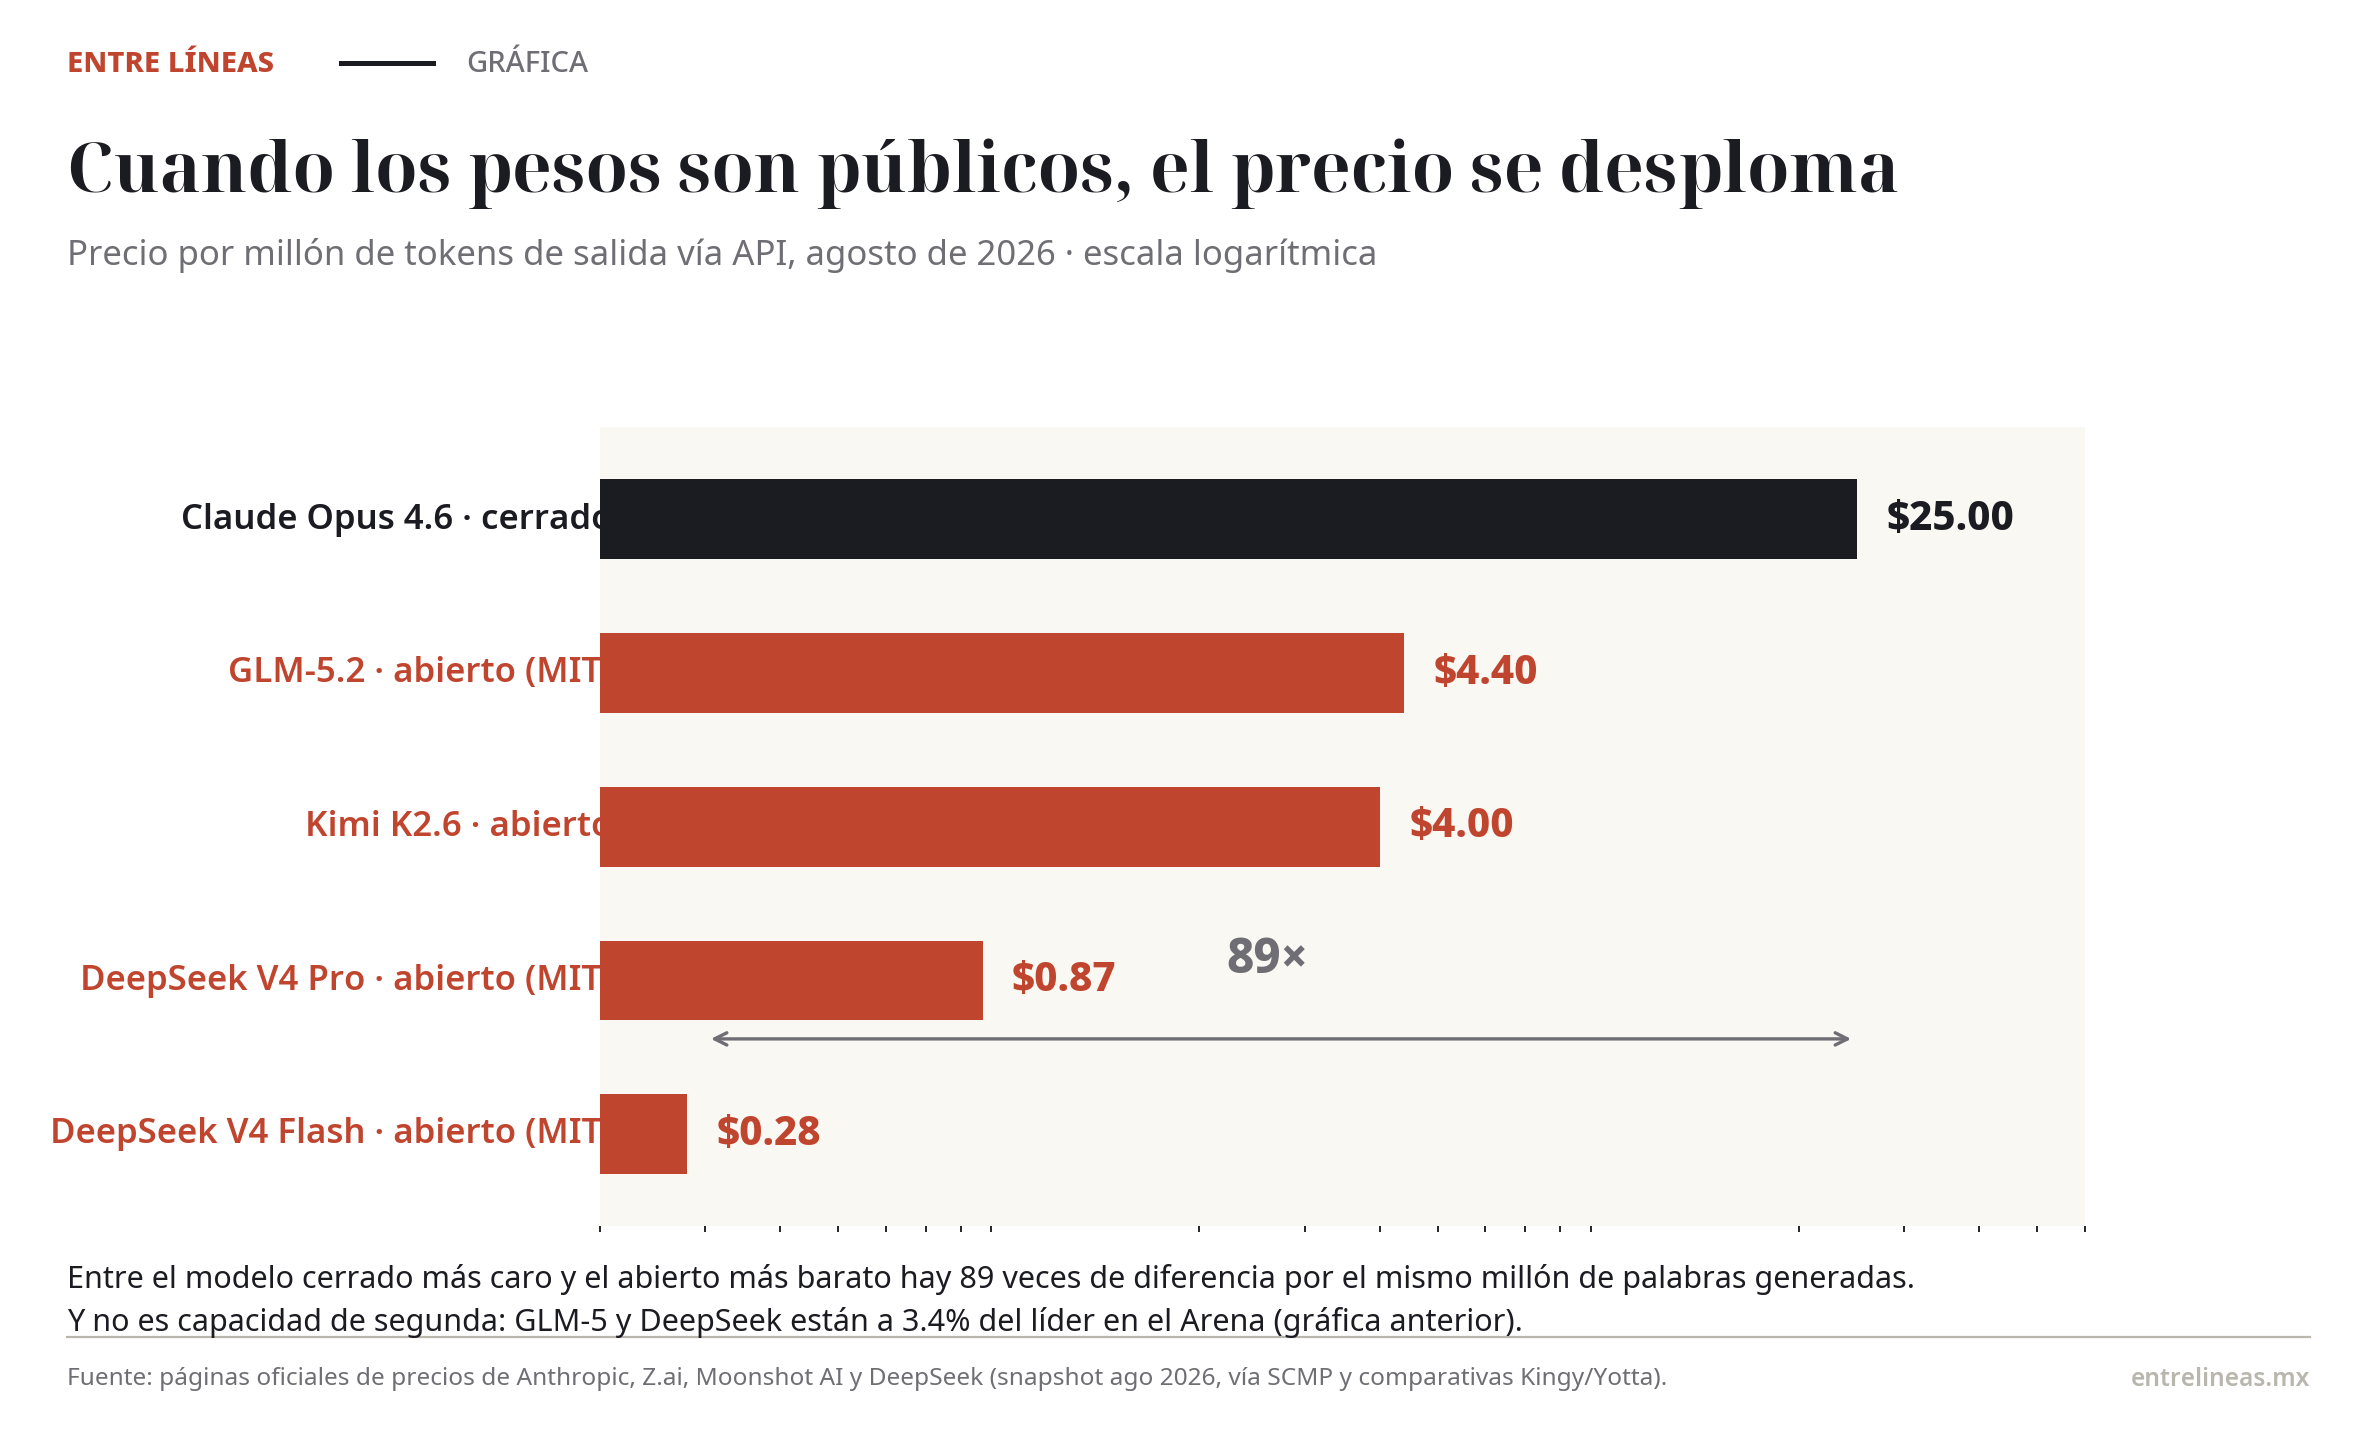
Y está el precio. Por un millón de tokens generados, el modelo cerrado más caro cobra 25 dólares; GLM-5.2, abierto y con licencia MIT, cobra 4.40 vía API; DeepSeek V4 Flash cobra 28 centavos. Ochenta y nueve veces de diferencia entre el extremo cerrado y el abierto, por una capacidad que está a 3.4 % de distancia en las mediciones.
Ahora, la dosis de escepticismo que estos números merecen.
Primera: la brecha se reabrió, de 0.5 % en 2024 a 3.4 % en 2026, y seis de los diez primeros lugares del Arena siguen siendo cerrados; lo abierto alcanza, pero no lidera.
Segunda: el propio AI Index advierte que los benchmarks públicos se saturan y se pueden entrenar para el examen (encontró tasas de preguntas inválidas de hasta 42 % en evaluaciones populares), así que 3.4 % en Arena no garantiza 3.4 % en tu trabajo real.
Tercera: “pesos abiertos” no es “código abierto”. Como dice James Landay, de Stanford HAI, puedes descargar el modelo pero no ver con qué se entrenó: es distribución abierta, no transparencia total. Y hay una tensión más: Alibaba y Zhipu han empezado a ofrecer algunos de sus modelos insignia solo como servicio cerrado. La ventana está abierta; nadie garantiza que lo siga para siempre.
La oportunidad mexicana
Durante tres años, la ecuación mexicana era frustrante: talento abundante, acceso escaso. Usar la mejor IA significaba rentarla por API a empresas extranjeras, con los datos saliendo del país, precios en dólares y la hoja de Excel de cualquier PYME temblando a fin de mes. Construir algo propio encima: un producto, no una suscripción, era casi imposible.
Nadie entrena un modelo frontera con presupuesto mexicano.
Los pesos abiertos rompen esa ecuación en cuatro puntos concretos:
Ya no hay peaje de entrada. Un equipo puede descargar un modelo a 3.4 % de la frontera mundial y trabajar sobre él sin pagar un dólar de licencia (GLM-5.2 y DeepSeek V4 usan licencia MIT, la más permisiva que existe).
Los datos se quedan en casa. Para una clínica, un despacho fiscal o una fintech mexicana, correr el modelo en infraestructura propia, o rentada en el país, significa que la información sensible deja de viajar a servidores ajenos. Eso no era posible con la IA de punta hasta hace meses.
Se puede especializar en lo mexicano. Con los pesos disponibles, un equipo puede afinar un modelo con español mexicano real, con legislación local, con catálogos del SAT, con el vocabulario de una industria específica. La IA deja de ser un producto importado con acento neutro y se vuelve materia prima local.
El precio convierte experimentos en procesos. A 28 centavos por millón de tokens, una pyme puede automatizar un flujo entero: facturas, cotizaciones, atención a clientes. Por lo que hoy paga de comisiones de una tarjeta corporativa. Antes, ese piloto moría en la primera factura.
Una empresa de logística en Monterrey corriendo un Qwen de 27 mil millones de parámetros en su propio servidor para optimizar rutas con sus datos históricos, sin que salgan del país; un despacho contable en la Ciudad de México procesando declaraciones con GLM-5.2 a una sexta parte del costo de su suscripción actual; un laboratorio universitario en la UNAM o el Tec enseñando sobre pesos reales de un modelo de frontera en lugar de diapositivas. Todo eso es técnicamente posible desde este verano.
La banca mexicana, en números
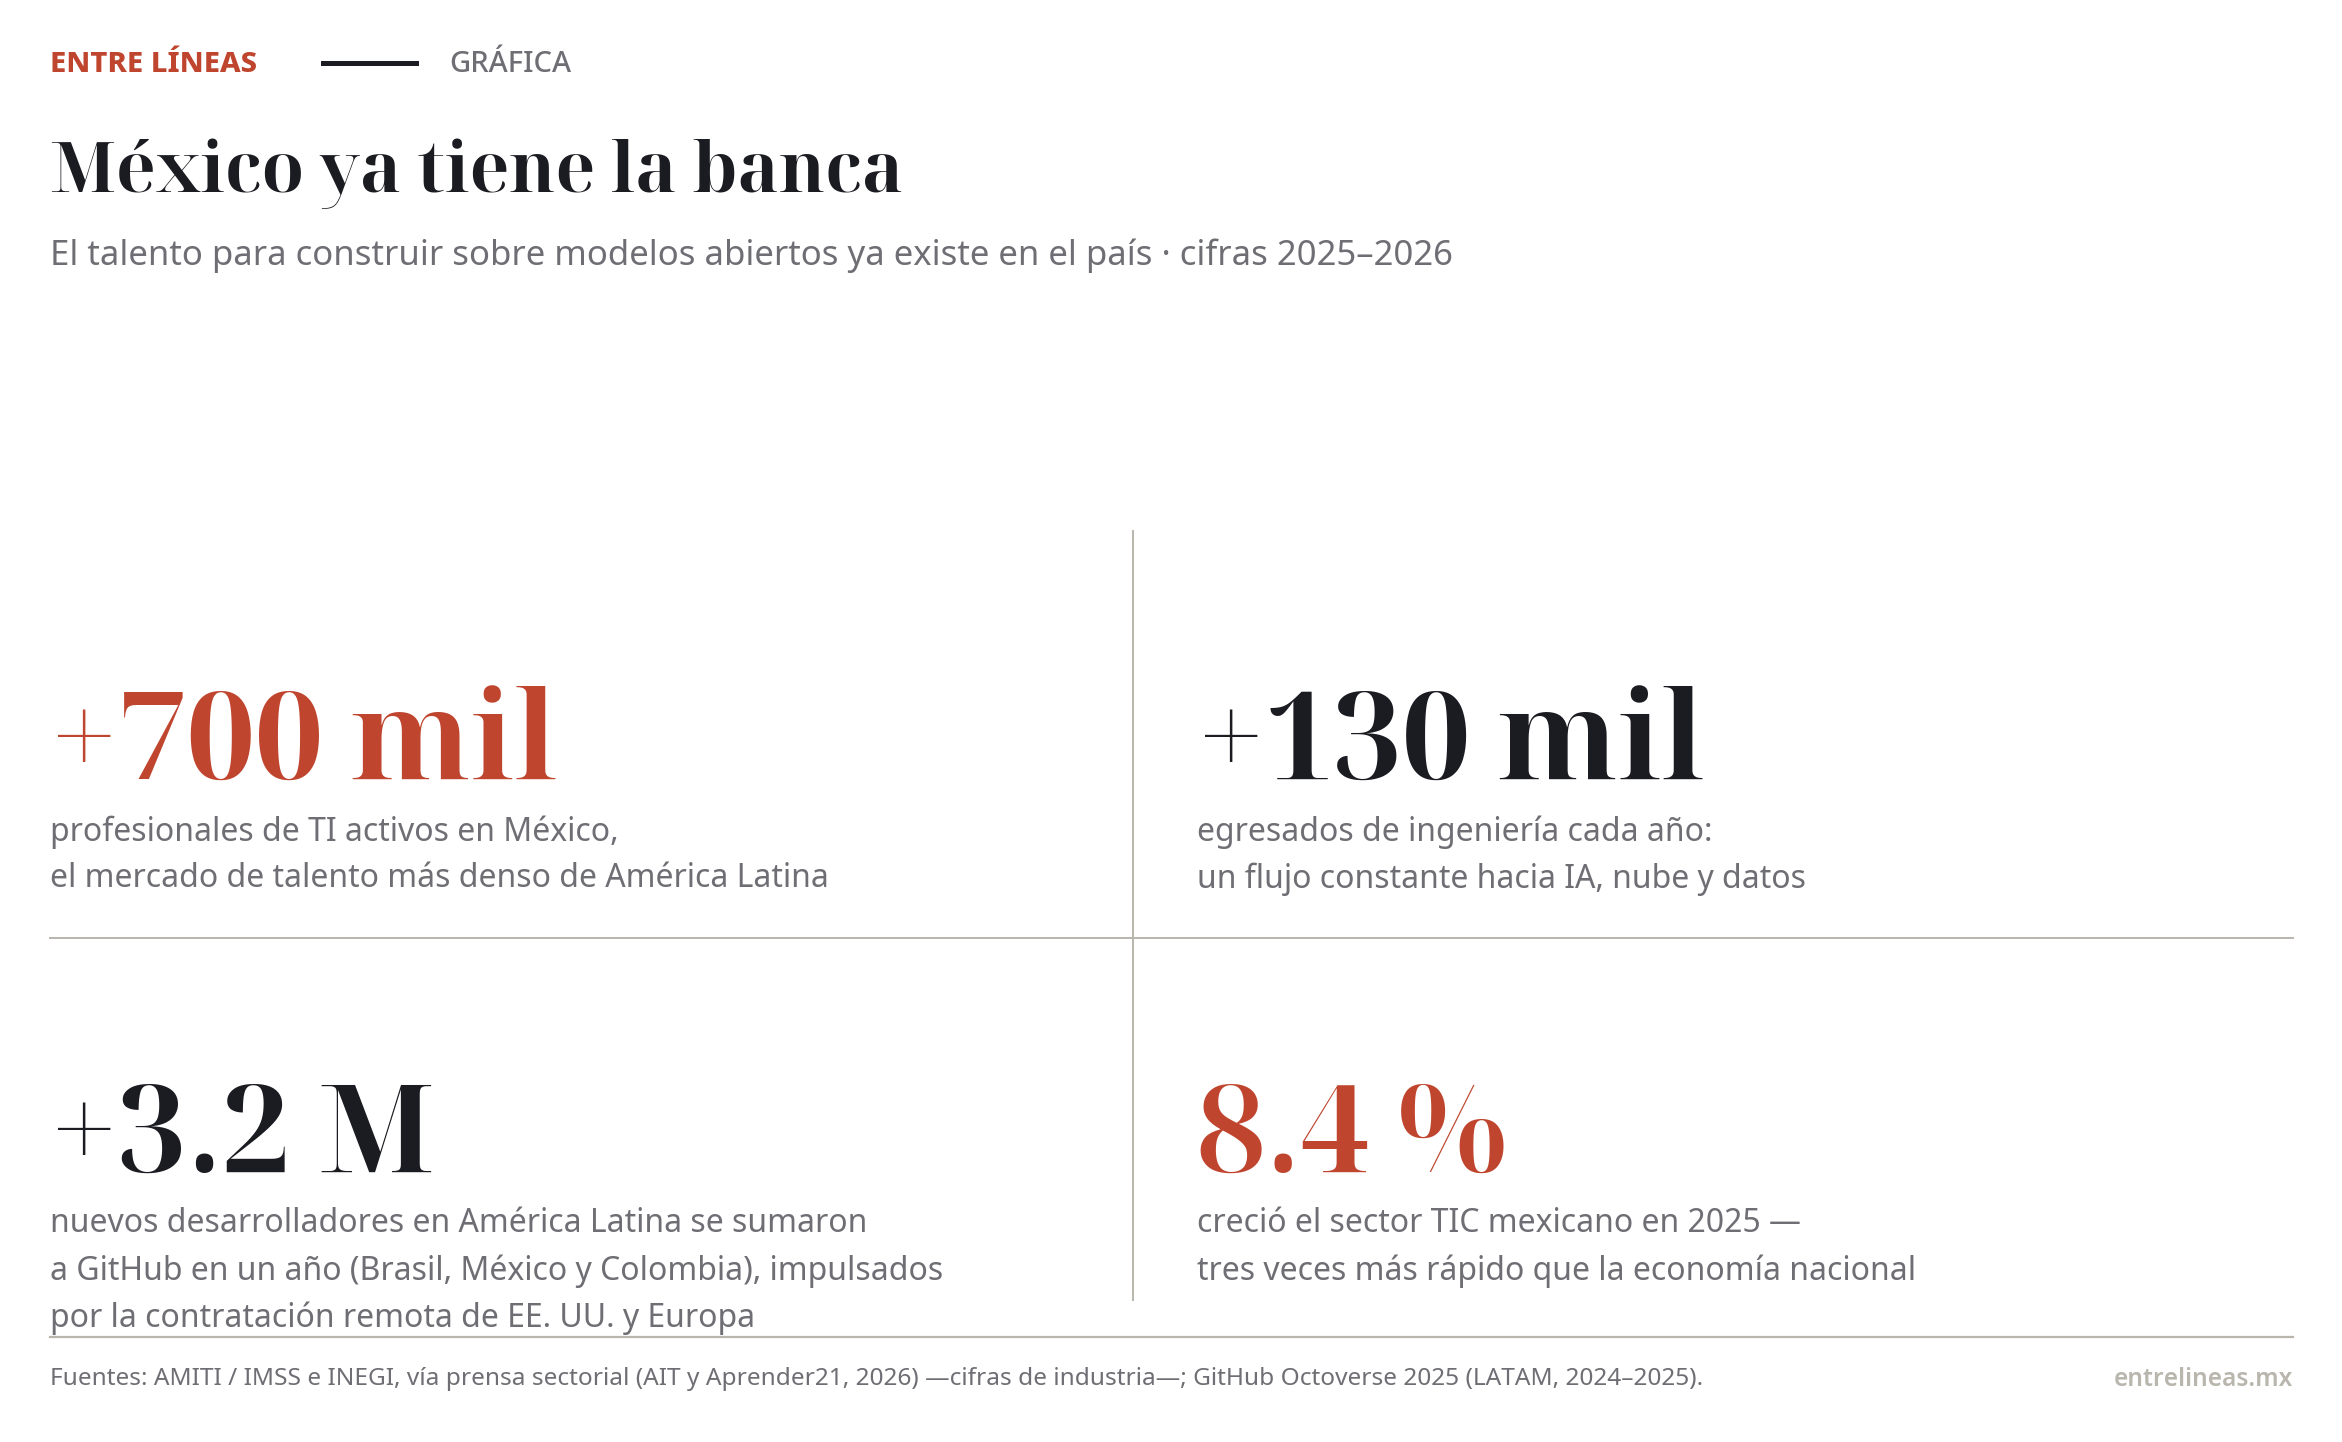
El otro lado de la oportunidad ya existe. México tiene más de 700 mil profesionales de tecnología activos, el mercado de talento más denso de América Latina, según cifras de la AMITI, y egresan más de 130 mil ingenieros cada año. El sector TIC creció 8.4 % en 2025, tres veces más rápido que la economía nacional. Y América Latina sumó 3.2 millones de desarrolladores nuevos a GitHub en un solo año, con Brasil, México y Colombia a la cabeza, impulsados por la contratación remota desde EE. UU. y Europa (Octoverse 2025).
El cuello de botella mexicano nunca fue la gente. Era el acceso a la capacidad de frontera. Ese cuello acaba de ensancharse.
No existen todavía datos públicos sobre cuántas empresas mexicanas están usando modelos de pesos abiertos. Lo anterior es una oportunidad demostrable técnicamente. Esa es exactamente la clase de vacío que este país debería apurarse a llenar.
¿Qué se puede hacer con esto?
Tres movimientos concretos, según dónde estés parado.
Si escribes código: esta semana puedes hacer tres cosas gratis o casi. Descarga un modelo pequeño de la familia Qwen (los de 27 mil millones de parámetros corren en una GPU de consumo) y pruébalo con tus tareas reales. Abre una API de DeepSeek V4 Flash y corre el mismo piloto por centavos. Y construye tu propia evaluación, veinte casos reales de tu trabajo, no benchmarks ajenos, porque la única pregunta útil es qué modelo es suficientemente bueno para tu tarea, a tu precio, con tu tolerancia al error.
Si diriges una empresa o un área: corre un piloto de dos semanas con datos propios comparando tu proveedor actual contra un modelo abierto vía API, y mide costo por tarea completada, no por token. Si manejas datos sensibles, agrega una variable que antes no existía: qué tanto vale que la información no salga de tu infraestructura. La respuesta puede cambiar la decisión aunque el modelo abierto sea un poco peor.
Si estás en una universidad o en política pública: los pesos abiertos son el primer material de enseñanza e investigación de IA de frontera que México puede costear. Laboratorios, tesis y prototipos de servicios públicos en español ya no requieren permiso ni presupuesto de frontera. Requieren decisión.
La pregunta que queda
Durante años, el consuelo mexicano frente a la IA fue decir que tenemos talento. Era cierto e insuficiente: el talento sin acceso a la tecnología de punta produce empleados remotos de empresas ajenas, no productos propios.
Esta semana, 150 empresas, incluidas las más poderosas del planeta, salieron a defender públicamente que la capacidad de frontera siga siendo descargable. La puerta no solo está abierta: la están sujetando desde adentro.
La pregunta que deja no es técnica ni geopolítica. Es mexicana y es incómoda: ahora que la frontera cabe en un disco duro, ¿cuántos equipos en este país van a construir algo propio con ella antes de que la ventana se cierre y cuántos van a seguir rentando la de otros?
La materia prima llegó. Lo que falta es lo que nunca nos ha faltado.
Fuentes
Research Institute for Tsinghua Scholars / NYU Shanghai — «150+ Companies Sign Open-Weights Letter, Anthropic Doesn’t» (28 de julio de 2026). Cronología de la carta, Kimi K3 y caída del índice de semiconductores.
Business Insider — «Microsoft, Nvidia, Meta, and Palantir’s Message to DC» (25 de julio de 2026). Firmas de OpenAI y Google; postura de Musk y Altman.
Forbes — «Nvidia Open Weights Letter Doubled To 50 Without Amazon And Anthropic» (25 de julio de 2026).
Shelly Palmer — «The Open-Weights Letter: What Happened, and Four Open Questions» (29 de julio de 2026). Posición de Anthropic.
Stanford HAI — AI Index Report 2026 y PDF del capítulo técnico. Brecha abierto–cerrado, Elo del Arena, advertencias sobre benchmarks.
Stanford HAI — «Open-Weight Models Aren’t Enough» (James Landay). Distinción entre pesos abiertos y código abierto.
The Implicator — «Stanford’s 2026 AI Index Puts US Lead Over China at 2.7%» (abril de 2026). Giro parcial de Alibaba y Zhipu hacia modelos cerrados; escalera de precios.
Gradient — «Everyone’s Watching the Wrong Benchmark» (julio de 2026). Epoch AI: lo abierto a ~4 meses de la frontera.
Yotta Labs — «Best Open-Source LLMs in 2026» (actualizado el 6 de agosto de 2026). Estado de Qwen 3.8, licencias MIT de GLM-5.2 y DeepSeek, hardware requerido.
Kingy.ai — «Best Open-Weight AI Models (2026)» (revisado el 28 de julio de 2026). Tabla de precios verificada contra páginas oficiales.
GitHub — Octoverse 2025 (octubre de 2025). Crecimiento de desarrolladores en América Latina.
AIT — «Nearshoring 2.0: México en datos» y Aprender21 — «Desarrollo de Software en México 2026». Cifras de talento TI (AMITI/IMSS/INEGI, reportadas por prensa sectorial).
Los precios y benchmarks se citan como snapshots de las fuentes indicadas y pueden cambiar; los datos de talento provienen de la industria (AMITI) vía prensa sectorial y se reportan como tales. Donde no existe evidencia de adopción específica en México, lo señalamos en el texto. Esta publicación no tiene relación comercial con ninguna de las empresas citadas.